

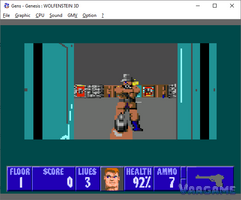
一款由爱好者移植到世嘉 Genesis / Mega Drive 的 Wolfenstein 3D 刚刚快了约 27% 到 29%,但没有人给它换更快的芯片,也没有重写游戏。haroldo-ok 在 2026年10月28日发表于 itch.io 的开发日志里介绍了 0.0.3 版,提速来自一个不那么光鲜的地方:移植版不再做那些没必要做的工作。天花板和地板上没有变化的行,每一帧都被重画;视频传输一个一个地发,每次都要暂停音频芯片;精灵还要穿过一列列空白像素。这些在屏幕上都看不见,却都在消耗帧数,把它们去掉就是整个故事。
快速信息
来源:Wolfenstein 3D Mega Drive 爱好者移植版的 v0.0.3 开发日志,2026年10月28日由 haroldo-ok 发表于 itch.io。本文关于该移植版的事实均出自这篇日志。
症状与基准背景:按作者在 Genesis Plus GX 模拟器上跑的基准,移植版绝对速度本来就慢,0.0.3 版在全部场景里提升了约 27% 到 29%,画面据称与原移植版 100% 像素相同。
数字,全部是作者的模拟器基准:起始房间 8.17 帧升至 10.51 帧,涨 28.6%;游览场景(靠近守卫与物品)6.86 帧升至 8.71 帧,涨 27.0%;原地旋转 8.01 帧升至 10.17 帧,涨 27.0%。
本文不声称的内容:这些只是模拟器基准,不是真实硬件实测;这是 itch.io 上的爱好者移植版,不是 id Software 的官方移植;约 10.5 帧的绝对速度仍然很慢;本版修复的暂停菜单黑屏,其原因在日志里没有说明,本文也不编造。
最后核实:2026年11月2日。
每一帧都在为看不见的工作付全价
先把诚实的大标题摆出来,因为日志本身配得上这份诚实,本文也不会把它吹大。按作者的模拟器基准,0.0.3 版在起始房间为 10.51 帧,游览场景(靠近守卫与物品)为 8.71 帧,原地旋转为 10.17 帧,这些是优化后的数字。优化前分别是 8.17、6.86 和 8.01。按作者自己的说法,全部场景的提升约为 27% 到 29%,画面据称与原移植版 100% 像素相同,所以提速不是靠把游戏做丑换来的。但谁都不该把这个案例读成“移植版现在跑得很快”的故事:约 10 帧的绝对速度仍然很慢。有意思的不是终点,而是时间都花在了哪里,因为这些开销都属于那种藏在普通帧里、永远不会表现为可见故障的类型。
日志里的优化清单,读起来像一份隐形工作清单。第一是背景:天花板和地板上那些帧与帧之间没有变化的纯色行,每一帧还是被重新渲染、重新上传到显存,尽管它们画出来的画面和已有的完全一样。第二是视频传输:每次传输都要暂停音频芯片,于是一帧里大量的小传输就要反复支付这个暂停。第三是算术:墙面例程和射线插值在做昂贵运算,用了缓慢的 32 位操作,而更便宜的算术本就可以胜任。第四是精灵:画一个精灵要走遍它的每一列,包括空白透明列,于是一把武器一帧里可能白白穿过 40 多个空白像素。第五是杂务:多余的手柄读取,比如每帧都去轮询 2 号玩家的手柄接口,还留在循环里。这些没有一个是戏剧性的故障,合在一起却是一种税,每帧收一次,永远收下去。
不再重做、改成打包、算术花得更少
针对每项开销的修复都直白得令人耳目一新,而这正是它能迁移到别的项目的原因。智能背景重绘的意思是:帧与帧之间没有变化的天花板与地板纯色行,不再重新渲染、不再重新上传到显存。像素既然一样,这份工作干脆就不做。直接 DMA 与 VBlank 打包的意思是:视频传输现在在 VBlank 期间直接写入硬件 DMA 寄存器,音频芯片每批只暂停一次,而不是每次传输都暂停一次。按作者的说法,仅这一项在模拟器基准里就带来了约 7% 的帧率提升,这很好地提醒我们:传输周边的开销可能比传输本身更贵。更快的墙面与射线计算,则是墙面例程用更快的指令复用已加载的贴图,射线插值改用优化过的 16 位算术、取代缓慢的 32 位操作。场景本身什么都没变,只是算术变便宜了。
精灵与杂务的修复补上了最后一块拼图。精灵现在会跳过空白透明列,武器不再每帧白白穿过 40 多个空白像素;2 倍武器缩放有了快速通道;屏幕列只计算真正与之重叠的活动精灵。多余的手柄读取也被拿掉了,包括每帧轮询 2 号玩家手柄接口的那一次。同一版本还修了一个真正影响玩家的故障:以前在暂停菜单里选“回到游戏”或按 B 键会导致黑屏,现在游戏可以正常恢复。日志没有说明黑屏的原因,本文也不会编造一个;只报告修复、把原因留空,这个区分很重要——一个靠猜测原因的案例,会教会读者也去猜测。全部加起来,结果的轮廓很清楚:移植版没有换更大的引擎,只是停止了一次又一次地为相同的像素、相同的暂停、相同的空白列付费,于是作者的模拟器基准从 6 到 8 帧的区间移到了 8 到 10.5 帧的区间。
能复用的部分
下面的步骤不是 Wolfenstein 3D Mega Drive 开发者在已述优化之外做过的事,而是把这些优化推广到你自己项目的清单,全部只停留在你自己的项目里。能复用的思路,是对每一帧都问一个问题:这份工作里,哪些部分得出的结果和上一帧完全一样,而我为什么还要再付一次钱?在现代机器上,同样的问题只是换了个量级:重绘未变区域的界面、重复上传静态缓冲的渲染循环、每次都自带 setup 开销的一批小传输、算术位宽超过数据所需的热点循环、穿过空白区域的绘制调用、出于习惯而非必要每帧都跑的轮询——这些都是同一种税,只是穿了不同的衣服。你不需要一台复古主机才欠得起这种税,只需要一个从不问“自上一帧以来什么变了”的帧循环。
周一早上照着做
在你自己的项目里,先做性能分析再优化:先量出帧时间真正花在哪里,再决定砍什么,这样修的是真实开销,而不是怀疑对象。
在你自己的项目里,找一项每帧结果与上一帧完全相同的工作,在什么都没变时跳过重做,同时留一个安全的兜底:一旦变化检测与画面不一致,就强制完整重绘。
在你自己的项目里,找出每次都自带 setup 开销的小传输或小更新,在平台允许的情况下把它们打包成一次操作,并且优化前后都要实测,让打包的效果被证明而不是被假定。
在你自己的项目里,检查最热的循环有没有算术位宽超过数据所需的情况,只在你已经验证过精度在取值范围内仍然成立的地方,才改用更便宜的算术。
在你自己的项目里,找出穿过空白区域的绘制或遍历,把空白区域跳过去,但要仔细测试边界,让被跳过的区域永远不会吞掉一个可见像素。
在你自己的项目里,核查每帧轮询与杂务里那些出于习惯而做的工作,只删掉或放慢你已经确认没有东西依赖的调用,之后重新测试输入与时序。